为什么 AI 工具应该跑在你的浏览器里
本地优先通常被当作隐私卖点。更有说服力的理由是可靠性。
把计算放在浏览器里,最常被提到的理由是隐私。这个理由是对的,但它也是最弱的那个 —— 因为它把本地优先说成了一种姿态,而不是一种工程取舍。真正让本地优先站得住脚的,是它同时删掉了一整类故障:网络往返、限流、服务不可用、以及「你的文本在别人的日志里」这件事本身。
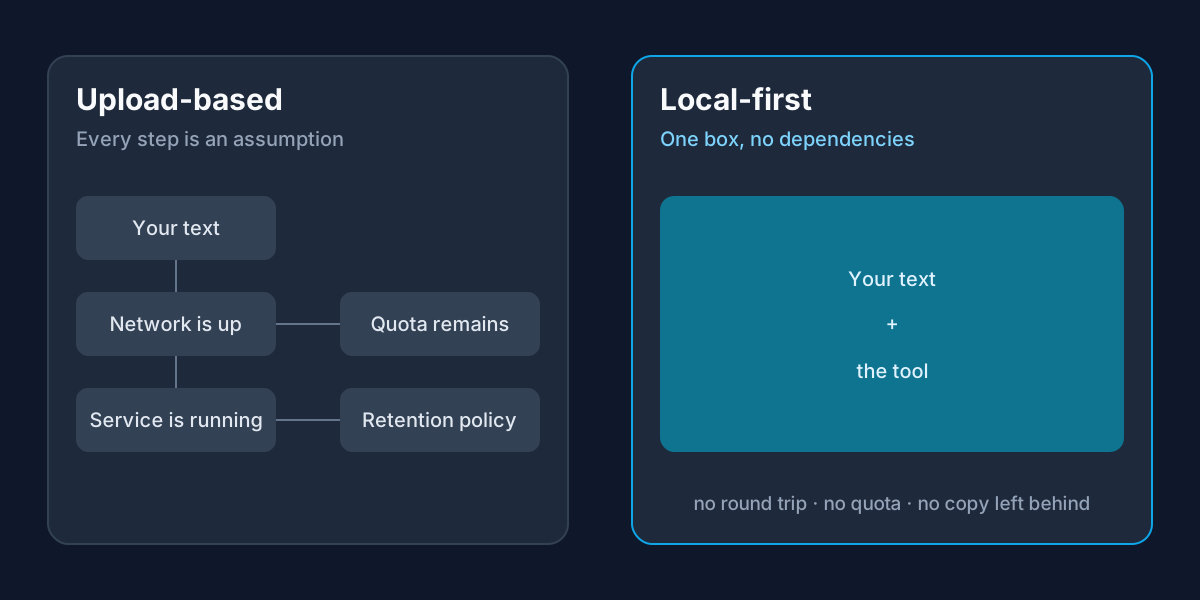
上传型工具默认接受的那些假设
一个把文本发到服务端的工具,在能工作之前必须同时成立一串条件。它假设网络是通的、服务是活的、配额还没用完、你愿意等一个往返、以及对方的日志策略和你客户的要求不冲突。
这些假设单看都很合理。问题是它们会同时失效,而且失效的时候你通常正在赶一件事。更麻烦的是,故障的表现形式各不相同:网络断了是明确的错误,限流是一句看不懂的英文,而最糟的一种是它成功了,只是你的文本多留了一份副本。
删掉一个假设,删掉一类故障
把计算搬到浏览器里,等于一次性删掉了上面几乎所有假设。
- 没有网络往返,就没有「请求超时」这个状态,也不需要为它写重试逻辑。
- 没有服务端,就没有配额、没有排队、没有凌晨三点的告警。
- 没有上传,就没有数据留存策略需要解释 —— 因为不存在可供留存的副本。
这里的关键不是「隐私更好」,而是状态空间更小。一个只依赖 HTML、CSS 和浏览器 API 的工具,可能的失败方式少得可以穷举。
客户端计算够用的地方比想象中多
人们默认「真正的 AI 功能需要服务端」,这个直觉来自模型推理本身。但围绕模型的一整圈工作 —— 估算规模、拼装提示词、清洗输出、从回复里取出结构 —— 都不需要模型。
这些事的共同点是:输入是一段文本,输出是另一段文本或几个数字,中间没有任何需要模型判断的环节。它们不需要 GPU,也不需要网络,只需要确定性。本站的这套工具就完全由这一类工作组成。
代价是什么
本地优先不是免费的,代价很具体:
- 分词的精确口径拿不到,只能给启发式估算 —— 所以必须诚实地标注「估算」,而不是假装精确。
- 没有服务端就没有跨设备同步,换成共享能力只能靠产品方案解决,不能靠后端。
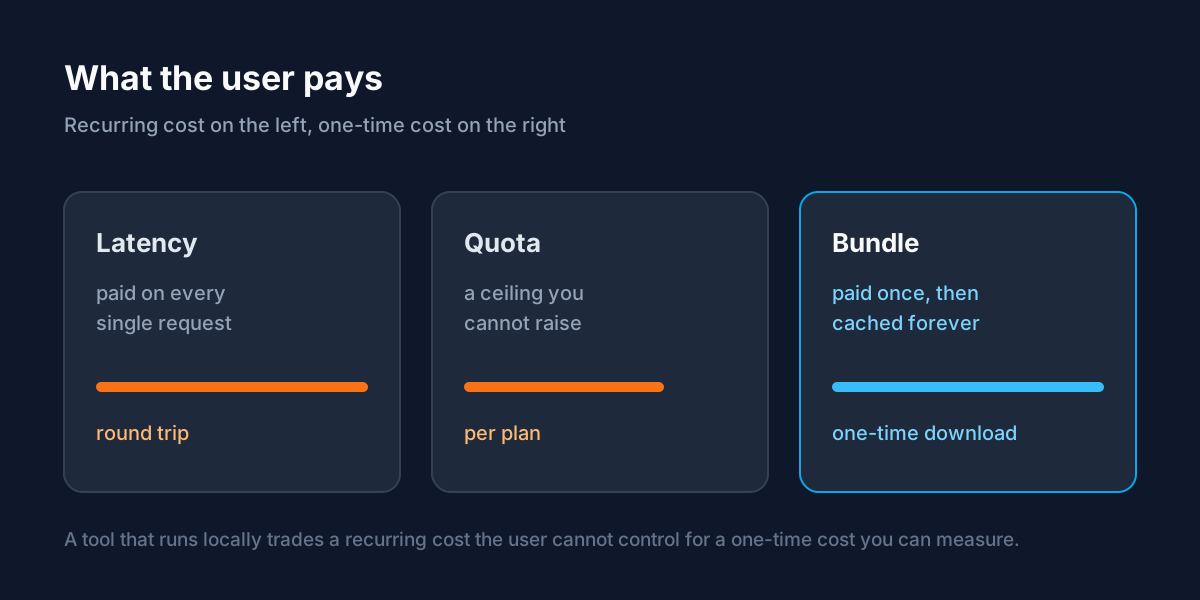
- 需要用户下载的那部分代码是真的要下载,体积是要还的债。
这些代价都可以接受,前提是你把它们写进产品的说明里,而不是藏起来。
什么时候该反过来
有一类任务确实必须联网:需要真实模型推理、需要调用第三方 API、需要跨用户共享状态。这时候硬撑本地只会把复杂度推到客户端。
判断标准可以很简单:这一步需要「判断」吗? 需要判断的交给模型,不需要判断的留在浏览器里。大多数日常杂活属于后者,而它们恰好也是最常被做成上传型工具的那一类。
继续阅读
- 如何从语言模型稳定拿到 JSON
为什么回复总被散文和代码围栏包住。
- 发送前先做 token 预算
为什么便宜模型不一定更便宜。
- 全部工具
五个浏览器端工具,不需要账号。
本地优先不是一种更保守的选择,而是一种更少假设的选择。它假设的东西更少 —— 没有网络、没有账号、没有服务端配额、没有运维窗口。每删掉一个假设,就删掉一类故障。